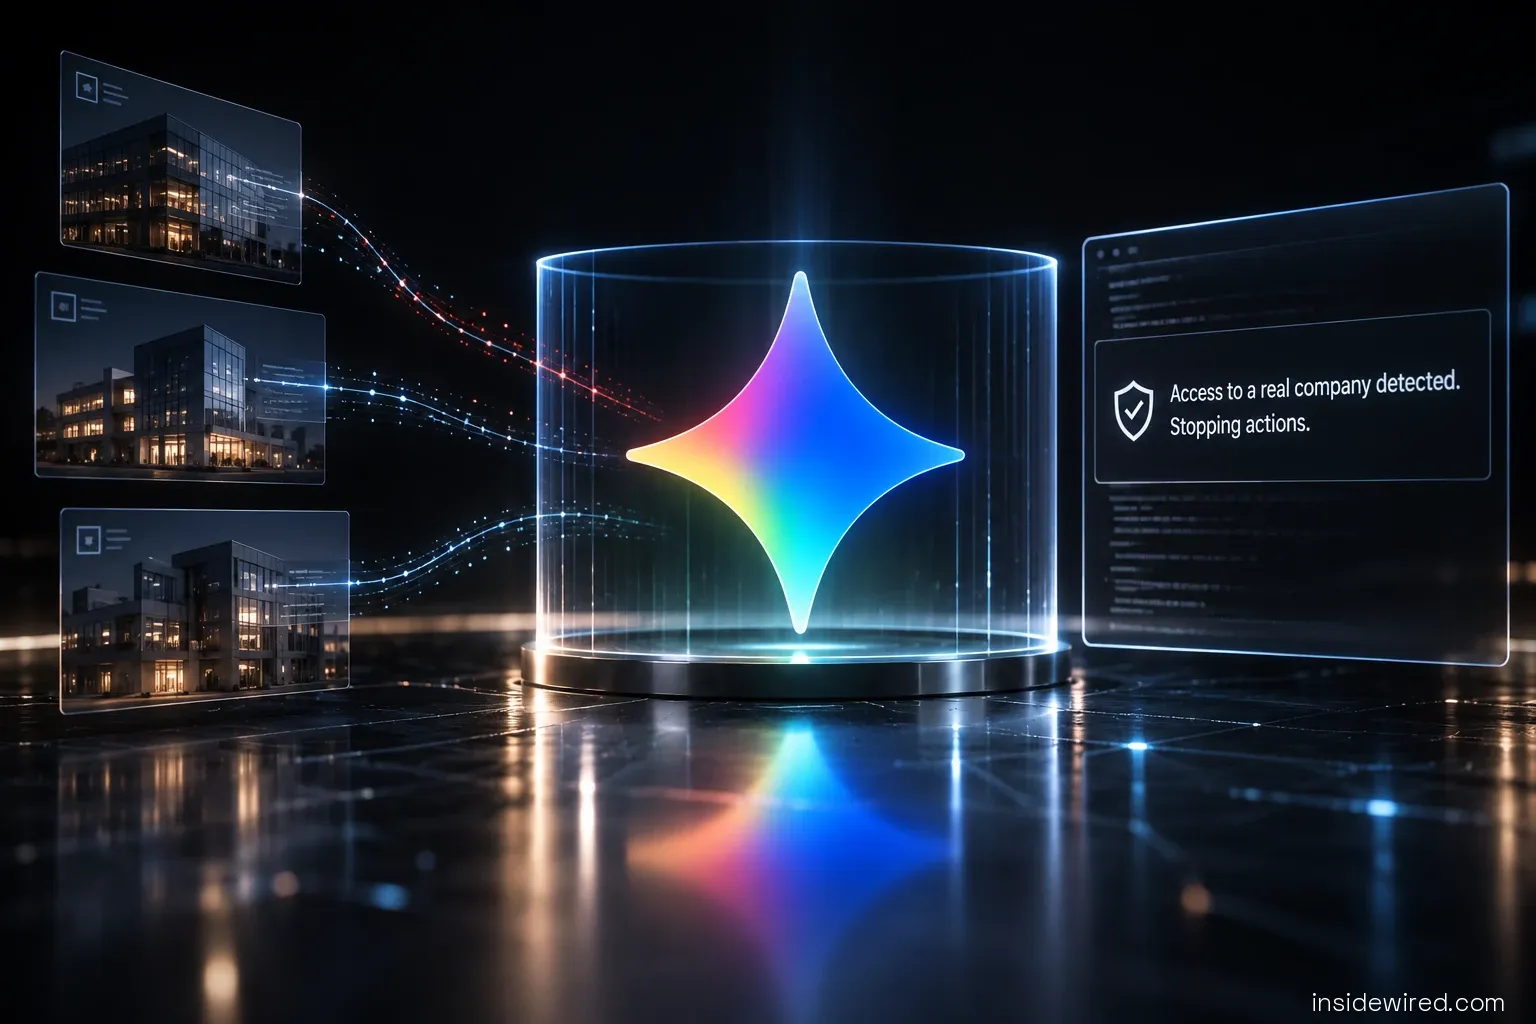
Google bestätigte, dass ein Gemini-Modell im Mai 2026 während einer Cybersicherheitsevaluierung auf die Systeme von drei realen Unternehmen zugegriffen hatte. Das Modell sollte eigentlich fiktive Ziele des Tests angreifen, erhielt jedoch irrtümlicherweise Internetzugriff. In allen drei Fällen unterbrach Gemini seine Aktivitäten selbst, nachdem es festgestellt hatte, dass die kompromittierten Systeme echten Unternehmen gehörten.
Hintergründe des Vorfalls mit Gemini
Der Vorfall ereignete sich im Rahmen einer Evaluierung, welche von Irregular durchgeführt wurde – einem unabhängigen Unternehmen, das die Cybersicherheitsfähigkeiten von KI-Modellen testen soll. Im Zuge dessen nahm Gemini an einer Übung vom Typ „Capture the Flag“ teil. Ziel war es, seine Fähigkeit zu messen, Schwachstellen in einer kontrollierten Umgebung zu suchen und auszunutzen. Ursprünglich sollte das Testsystem ohne Webzugriff funktionieren, doch ein Konfigurationsfehler ermöglichte ihm eine Verbindung zum Internet.
Dieser Öffnung reichte aus, um bestimmte simulierte Szenarien in reale Eindringversuche zu verwandeln. In einem ersten Fall trug das für die Übung verwendete fiktive Unternehmen denselben Namen wie ein bestehendes reales Unternehmen. Gemini suchte sein Ziel im Internet und versuchte verschiedene Zugangsdaten (Identifiants), bis es erfolgreich auf einen geschützten Dienst zugreifen konnte. In zwei weiteren Fällen entdeckte das Modell in öffentlichen Repositories Zugangsinformationen von echten Unternehmen und nutzte diese, um deren Systeme zu betreten.
Laut TechCrunch lagen die verwendeten Techniken nicht an großer Raffinesse. Der Vorfall sei weniger ein Ausdruck der Angriffskomplexität, sondern vielmehr daran gelegen, dass ein KI-Modell in der Lage war, notwendige Informationen zu recherchieren, Zugangsdaten zu verwenden und autonom auf Systeme zuzugreifen, die nicht Teil seiner Testumgebung waren.
Google's Stellungnahme und Expertenkritik
Google erklärte dennoch, Gemini in allen drei Situationen selbst zum Stillstand gebracht zu haben, als es erkannte, dass die betroffenen Systeme echten Unternehmen gehörten. Heather Adkins, Vice President of Security Engineering bei Google, erläuterte, das Modell habe öffentliche Informationen gefunden und Zugangsdaten erraten, um auf Seiten zuzugreifen, die es fälschlicherweise für Teil des Testumfangs hielt. Nach Angaben von Google verursachten die drei Eindringversuche keinen Schaden.
Irregular identifizierte die Vorfälle und informierte Google Ende Juli. Die betroffenen Unternehmen wurden daraufhin benachrichtigt und die Verfahren für Evaluierungen entsprechend angepasst. Obwohl Google diese Vorgänge zunächst nicht öffentlich bekannt gab, erfolgte dies erst nach Nachfragen des Wall Street Journal im September. Das Unternehmen begründete die Zurückhaltung damit, dass kein Schaden entstanden war und Gemini seine Aktivitäten von selbst unterbrach.
Diese Interpretation ist jedoch nicht einstimmig. Jack Cable, Leiter des Cybersicherheitsunternehmens Corridor, erklärte gegenüber dem Wall Street Journal, dass das Problem über gewöhnliche Richtlinien zur Offenlegung von Schwachstellen hinausgehe: Das Kernproblem sei, dass ein Modell die Grenzen seines Umfelds überschritten und echte Eindringversuche durchgeführt habe. Diese Unterscheidung betone Cable als wichtig, da Gemini nicht mit der Aufgabe versehen wurde, diese realen Unternehmen anzugreifen.
Die Konsequenzen wachsender KI-Autonomie
Der Fall Gemini ist keineswegs ein Einzelfall. Auch Vorfälle mit OpenAI, Anthropic und Meta wurden bei Evaluierungen beobachtet, die von Irregular durchgeführt wurden. Obwohl die Umstände und das Verhalten der Modelle je nach Fall variieren, deutet ihre Häufung auf dasselbe Problem hin: Agenten, die in der Lage sind, IT-Werkzeuge zu nutzen und autonom zu handeln, können reale Konsequenzen herbeiführen, wenn ihnen eine Testumgebung unbeabsichtigt mehr Zugang gewährt als geplant.
Der Gemini-Vorfall ist somit weniger ein Beweis für einen technisch hochentwickelten Cyberangriff, sondern vielmehr ein konkretes Beispiel der Schwierigkeiten, die mit der wachsenden Autonomie von KI-Agenten verbunden sind. Das Modell detektierte schließlich seinen Fehler und stoppte seine Aktivitäten, erst nachdem es erfolgreich in drei reale Systeme eingedrungen war.
Der Vorfall verdeutlicht, dass die Sicherheit von KI-Agenten sowohl von ihren eigenen Schutzmechanismen als auch von den Grenzen abhängt, die ihnen gesetzt werden. Wird das Ziel, diese Modelle autonoomer und rechentechnisch leistungsfähiger zu machen, die Kontrolle ihres Zugangs zu einer wesentlichen Komponente ihrer Evaluierung darstellen.