Google ne présente pas Gemini 4 Argon comme un chatbot plus bavard, mais plutôt comme un modèle capable de poursuivre un travail technique pendant une durée beaucoup plus longue. Sa limite de sortie annoncée d’un million de tokens ouvre la voie à des migrations de code et à des recherches à grande échelle ; elle déplace également le défi vers le contrôle, le coût et la vérification de trajectoires que personne ne pourra relire intégralement en temps réel.
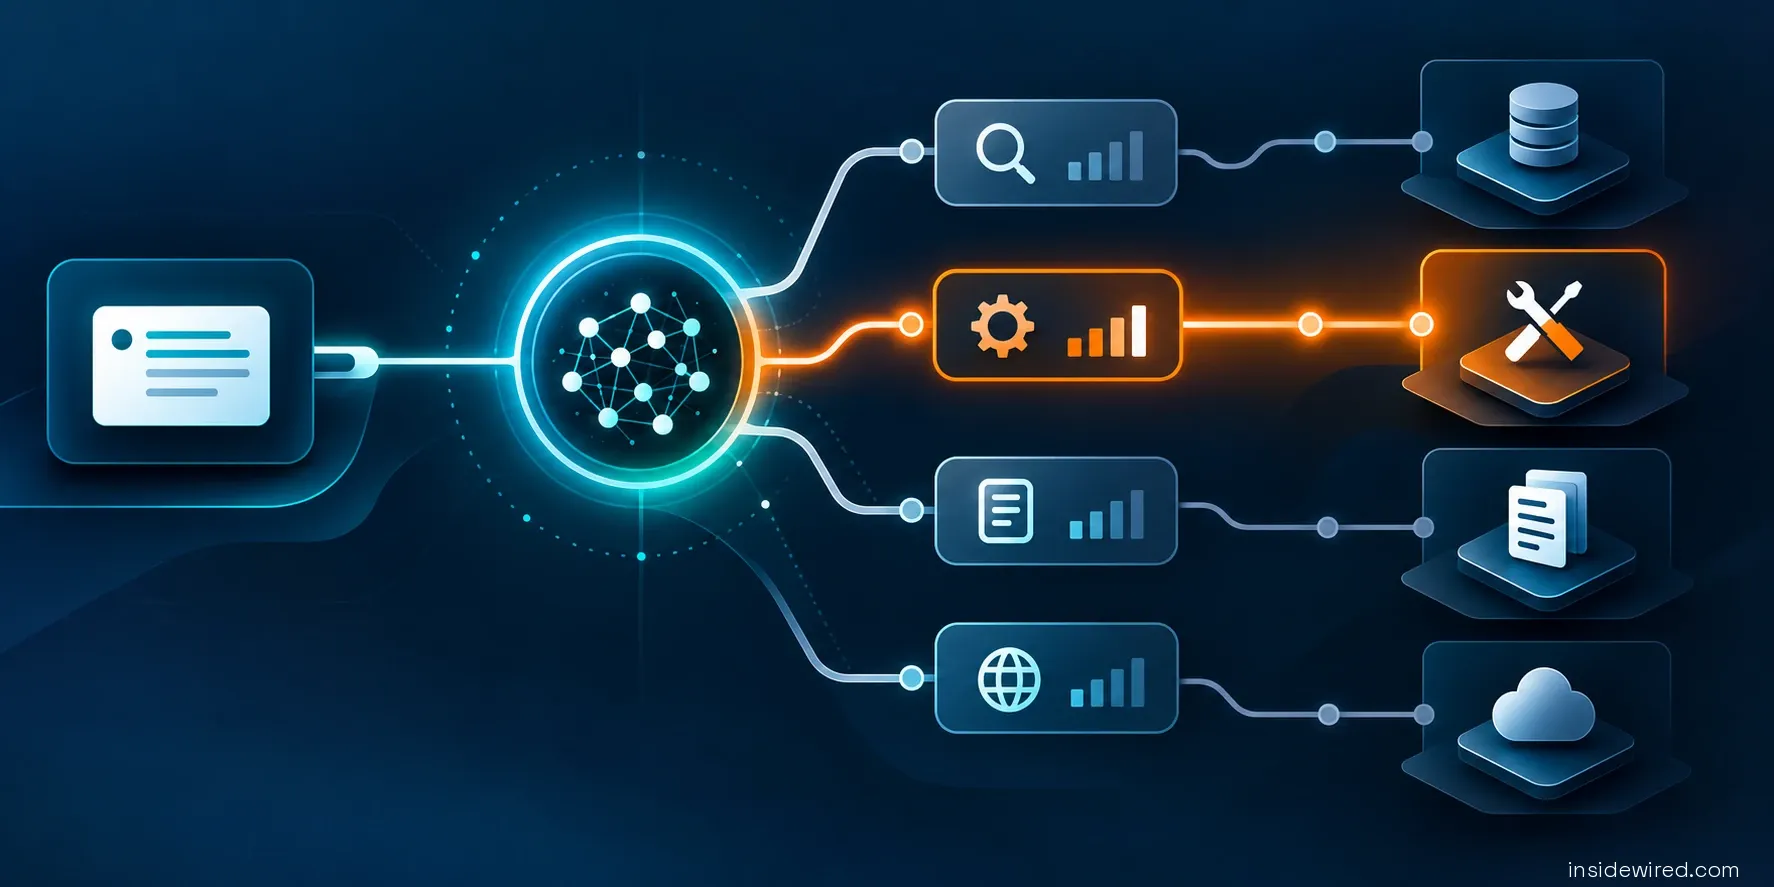
Un million de tokens en sortie n’est pas une invitation à produire un rapport interminable. Pour Google, cette nouvelle limite de Gemini 4 Argon doit permettre au modèle d'accomplir des travaux composés de milliers d'étapes : examiner un vaste dépôt de code, proposer une migration, exécuter des tests, corriger les erreurs et recommencer. La génération devient alors la trace d’une trajectoire d’agent plutôt qu’un simple texte linéaire destiné à être lu du début à la fin.
Les enjeux techniques du million de tokens
Le saut annoncé est spectaculaire : Google évoque un passage de 64 000 à un million de tokens en sortie. Il est crucial de ne pas confondre cette limite avec la fenêtre de contexte, qui mesure ce que le modèle peut recevoir. Ici, il s'agit de la quantité maximale que le système peut produire pendant une tâche.
Dans un usage technique avancé, ces tokens peuvent contenir du code, des commandes, des analyses intermédiaires et des corrections successives. L’intérêt réside donc moins dans la longueur visible en elle-même que dans la capacité à rester engagé sur un objectif complexe.
Google met en lumière plusieurs résultats internes : Argon aurait contribué à libérer environ 300 tébioctets de stockage, avec un potentiel estimé entre 500 tébioctets et un pébioctet. Il a également participé à des migrations vers Rust, notamment sur quelque 800 000 lignes du noyau Fuchsia. Le groupe mentionne aussi une amélioration de 40 % dans une tâche d’optimisation quantique. Ces exemples illustrent l'échelle visée, mais ils restent des cas sélectionnés par le fournisseur et nécessiteront d'être documentés et reproduits pour distinguer la capacité générale d'une intégration très encadrée.
Les benchmarks publiés confirment cette orientation : Google annonce 77,9 sur DeepSWE et 51,3 sur AutomationBench. Un score élevé peut indiquer que le modèle planifie, code et utilise des outils avec efficacité. Cependant, cela ne mesure pas nécessairement la maintenabilité d’une modification, ni la qualité d’une décision métier ou la capacité à reconnaître qu’un objectif initial est mal formulé. Plus la trajectoire est longue, plus une petite erreur initiale risque de contaminer un grand volume de travail avant d'être détectée.
La gouvernance face à l’autonomie accrue
L’augmentation de la limite en tokens pose inévitablement des défis de supervision. Aucun responsable ne pourra relire ligne par ligne une sortie de cette taille. Par conséquent, la confiance devra reposer sur les validations intermédiaires : tests automatiques rigoureux, vérification des types, application des politiques d’accès, comparaisons de résultats et approbation humaine aux étapes irréversibles. Un agent long doit être divisé en phases observables avec des budgets et des critères d’arrêt clairs pour éviter qu'il ne dispose d’un environnement trop ouvert simplement par sa grande capacité.
Aspect économique et déploiement
Le coût participe directement à cette gouvernance. Google annonce, pour la phase d’introduction, un tarif de 2 dollars par million de tokens en entrée et 10 dollars en sortie. Une trajectoire consommant toute la limite coûterait donc au moins dix dollars uniquement pour la génération, avant même de considérer les nouvelles tentatives, les appels d’outils ou le contexte. Bien que ce montant puisse paraître faible face au travail d'une équipe d'ingénieurs, il devient significatif lorsque des centaines d’agents sont lancés ou qu'il y a des boucles mal contrôlées. L'indicateur de valeur utile sera donc le coût d’une tâche validée, et non celui d’un token consommé.
Concernant la disponibilité, Google réserve initialement Argon aux défenseurs cyber sélectionnés par l’intermédiaire de Fairwind, avant une ouverture plus large. Cette approche témoigne d'une reconnaissance implicite que les capacités d’autonomie et de code peuvent servir aussi bien à la défense qu'à l’offensive. Le déploiement progressif permet au groupe d'observer les usages réels, de tester les contrôles nécessaires et d’ajuster progressivement les limites.
L'impact pour les développeurs
Pour les développeurs, Argon a le potentiel de modifier radicalement la granularité du travail délégué à l'IA. Jusqu'à présent, on délégait souvent une fonction spécifique, un test local ou une analyse circonscrite. Une trajectoire très longue permet désormais d’envisager la modernisation d’un sous-système entier, une recherche documentaire exhaustive ou une optimisation générant et évaluant de nombreuses hypothèses méthodologiques.
La responsabilité ne disparaît pas avec cette puissance. Il est impératif de définir clairement l’objectif global, de construire un environnement de test robuste et de décider quelles modifications sont suffisantes pour être conservées et validées humainement.
En conclusion, la promesse d'Argon n'est donc pas simplement « plus de texte ». Elle consiste à maintenir une continuité de raisonnement et d’action sur une durée jusqu'alors inatteignable. Si cette continuité s’accompagne de points de contrôle stricts, elle peut réduire le coût des travaux massifs et pénibles. Sans visibilité structurelle sur les étapes intermédiaires, elle risque au contraire de générer des changements considérables dont la logique deviendra difficile à auditer. Le million de tokens est avant tout une infrastructure conçue pour les agents ; sa véritable valeur dépendra intrinsèquement de la qualité du système de validation qui sera construit autour d'elle.