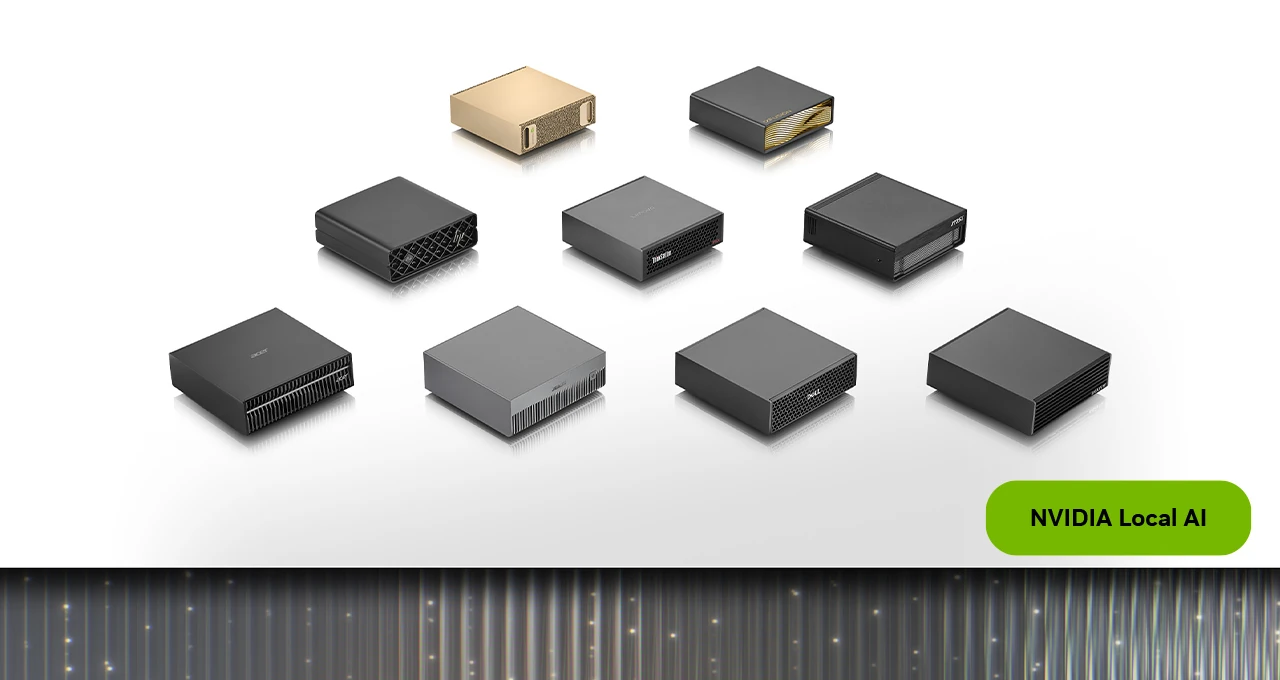
Nvidia décline son mini-supercalculateur DGX Spark en version 64 Go à 4 999 dollars, et propose de relier deux unités pour atteindre 128 Go de mémoire agrégée. L’offre rend l’écosystème GB10 plus accessible que le modèle 128 Go, mais le mot « accessible » reste relatif : la machine vise des équipes qui valorisent la confidentialité et le prototypage local, pas un grand public en quête d’un PC IA.
Le DGX Spark 64 Go : Une porte d'entrée dans l'IA locale
Nvidia présente le nouveau DGX Spark 64 Go comme une manière de démarrer avec le développement local de modèles d’intelligence artificielle. La machine conserve le format compact et l’architecture GB10 de sa famille, mais diminue la mémoire unifiée par rapport à l'option 128 Go. Avec un prix annoncé de 4 999 dollars et une disponibilité attendue dès le 23 octobre chez les partenaires, il s'agit clairement d'un outil professionnel spécialisé plutôt que d'un mini-PC conventionnel.
Gestion de la mémoire et modélisation
La capacité mémoire est l’élément central de cette catégorie d'équipement. Pour exécuter un modèle en local, c'est souvent la quantité disponible qui détermine ce qui peut être chargé avant même que la puissance de calcul ne soit sollicitée. Nvidia indique qu’un DGX Spark 64 Go peut prendre en charge des modèles allant jusqu’à environ 100 milliards de paramètres, selon le format et la quantification utilisés. Ce chiffre sert d'ordre de grandeur pour le prototypage, car il ne garantit pas que tous ces modèles seront rapides ni que l’ensemble de la mémoire sera disponible pour le contexte ou les outils annexes.
L'astuce clé mise en avant par Nvidia est la capacité de relier deux unités grâce à l’interface ConnectX-7. Ce regroupement permet d’atteindre un pool de 128 Go, et Nvidia évoque alors l’exécution de modèles pouvant atteindre jusqu’à 200 milliards de paramètres. Cette configuration est particulièrement attrayante pour une équipe qui souhaite acquérir une première machine puis étendre progressivement sa capacité. Néanmoins, cette approche doit être confrontée à celle d'un système 128 Go intégré : le déploiement d'un modèle introduit des communications entre les boîtiers, ce qui ajoute de la complexité logicielle et des limites dépendant des architectures supportées.
Au-delà des spécifications techniques
Les performances annoncées sont très spécifiques. Nvidia fait état d’une double bande passante et de jusqu’à 1,7 fois les performances sur un test mené avec Qwen 3.8 27B. Cependant, comme tout résultat provenant du constructeur, il décrit un scénario précis. Les utilisateurs doivent considérer que la performance varie selon la quantification, la longueur du contexte, le nombre d’utilisateurs et le moteur d’inférence utilisé. Il est donc nécessaire de réaliser des tests indépendants pour mesurer précisément le débit de tokens, la latence au premier token, la consommation électrique et la stabilité sur de longues sessions.
La valeur intrinsèque du DGX Spark réside autant dans son environnement logiciel que dans sa fiche technique matérielle. Nvidia fournit une pile logicielle complète incluant CUDA, des outils pour les modèles Nemotron, Ollama, vLLM et PyTorch, ainsi qu’un assistant dédié à la création de clusters. Pour une petite équipe, l'économie en temps gagnée sur l'intégration peut justifier une partie du coût initial. Si un assemblage moins coûteux utilisant des composants grand public peut offrir plus de performances brutes, il exige par contre davantage de configuration, de maintenance et potentiellement des compromis mémoire.
Les bénéfices du calcul local pour les entreprises
Le choix d'un calcul local répond à trois besoins opérationnels majeurs :
- Confidentialité : Des données sensibles (documents, code ou recherches) restent physiquement au sein de l’organisation.
- Prévisibilité : L'entreprise ne paie pas pour chaque token consommé, et le fonctionnement n'est pas interrompu par une modification des services distants.
- Expérimentation bas niveau : Les équipes ont un accès direct au modèle, aux poids et à l’infrastructure sous-jacente.
Ces bénéfices doivent être mis en balance avec les coûts énergétiques, administratifs et le renouvellement matériel. À 4 999 dollars, ce coût n'est pas synonyme de "bon marché". Deux unités dépassent déjà le prix de nombreuses stations de travail et se rapprochent du coût d’une infrastructure qu'il faut comparer à la location de GPU dans le cloud. Une équipe dont les charges sont irrégulières pourrait préférer louer sa capacité, tandis qu'une autre qui manipule quotidiennement des données sensibles ou développe hors ligne est mieux placée pour amortir l'achat d'un équipement local. Le calcul doit donc intégrer le taux d’utilisation, et non uniquement le prix d’acquisition.
Conclusion : Une réduction de barrière, pas une démocratisation
Le format compact du DGX Spark ouvre des usages précédemment impossibles, que ce soit en laboratoire, au bureau ou sur le terrain, contrairement à un serveur traditionnel. Cependant, il ne transforme pas l'appareil en ordinateur portable ni en poste de travail généraliste ; les considérations de bruit, de chaleur, de connectique et de sécurité des données restent primordiales dans une installation réelle.
En définitive, le DGX Spark 64 Go représente une réduction de barrière à l'entrée sur la pile Nvidia, permettant d’initialiser un environnement avec moins de mémoire et de prévoir une extension modulaire. Sa pertinence sera maximale pour les équipes qui ont une connaissance précise des modèles qu'elles souhaitent exécuter, leur fréquence d'utilisation, et pourquoi le cloud ne répond pas à leurs exigences. Pour le reste du marché, le coût élevé et la complexité potentielle du jumelage risquent de transformer la promesse de souveraineté locale en matériel sous-utilisé.
Avant tout achat, il sera crucial de tester le modèle cible sur 64 Go, d'estimer une année d’utilisation et de comparer le coût de deux Spark reliés à celui d’une machine intégrée 128 Go ou du cloud : le choix optimal dépendra avant tout du taux d'usage, et non du slogan « IA locale ».