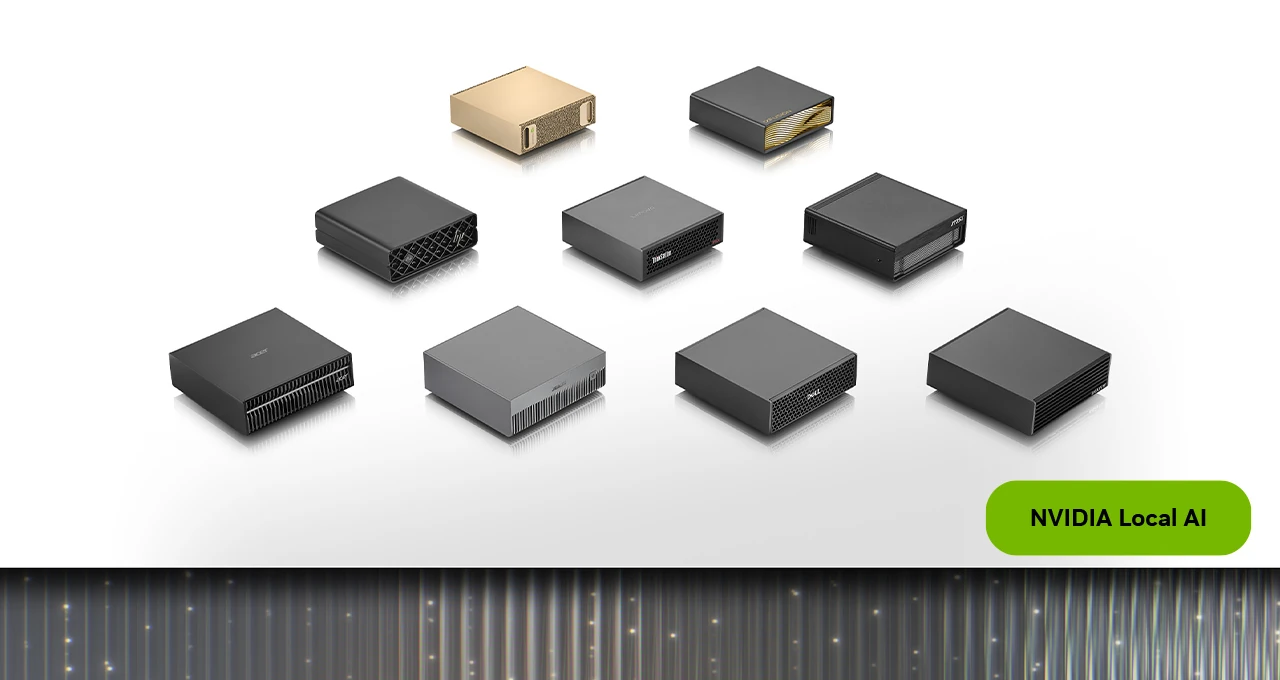
Nvidia lanceert zijn mini-supercomputer DGX Spark in een versie van 64 Go voor $4.999 en biedt aan om twee units te verbinden om zo 128 Go geaggregeerd geheugen te bereiken. Het aanbod maakt het GB10 ecosysteem toegankelijker dan de 128 Go-versie, maar het woord 'toegankelijk' blijft relatief: de machine is gericht op teams die waarde hechten aan privacy en lokale prototyping, niet op een breed publiek op zoek naar een AI-pc.
De DGX Spark als Instapmodel voor AI-ontwikkeling
Nvidia presenteert de nieuwe DGX Spark 64 Go als een instapmodel voor het lokaal ontwikkelen van kunstmatige intelligentie-modellen. De machine neemt het compacte formaat en de GB10-architectuur van de familie over, maar verlaagt het uniforme geheugen ten opzichte van de 128 Go-versie. De aangekondigde prijs van $4.999, met beschikbaarheid vanaf 23 oktober bij partners, bevestigt dat dit een gespecialiseerd professioneel instrument is en geen conventionele mini-pc.
Geheugen is het centrale element in deze categorie. Om een model lokaal uit te voeren, bepaalt de beschikbare capaciteit vaak wat er geladen kan worden, zelfs voordat de rekencapaciteit wordt geraadpleegd. Nvidia geeft aan dat een DGX Spark 64 Go modellen met maximaal ongeveer 100 miljard parameters kan ondersteunen, afhankelijk van het formaat en de kwantisering. Dit plafond betekent echter niet dat al deze modellen snel zijn of dat het geheugen volledig vrij blijft voor context en tools. Het geeft een orde van grootte aan voor prototyping.
Modulariteit en Prestatievergelijkingen
De sleutel die wordt benadrukt is het verbinden van twee units met behulp van de ConnectX-7 interface. Het totaal bereikt dan 128 Go, en Nvidia spreekt over de uitvoering van modellen tot 200 miljard parameters. Deze configuratie is aantrekkelijk voor een team dat eerst een machine wil aanschaffen en vervolgens zijn capaciteit wil uitbreiden.
Het is echter belangrijk deze opzet te vergelijken met een geïntegreerd 128 Go-systeem: het distribueren van een model introduceert communicaties tussen de behuizingen, wat zorgt voor softwarecomplexiteit en beperkingen op basis van ondersteunde architecturen.
Nvidia kondigt twee keer zoveel bandbreedte en tot wel 1,7 keer zo'n prestaties aan tijdens een test uitgevoerd met Qwen 3.8 27B. Zoals altijd beschrijft een resultaat geleverd door de fabrikant een specifiek scenario. De prestaties zullen variëren met kwantisering, contextlengte, aantal gebruikers en de inferentie-engine. Onafhankelijke tests moeten daarom de tokendoorvoer, de latentie van het eerste token, verbruik en stabiliteit over lange sessies meten.
De Waarde van Lokale Rekening en Ecosystem
De waarde van de DGX Spark zit evenveel in zijn ecosysteem als op zijn technische fiche. Nvidia levert een stack die CUDA, tools voor Nemotron-, Ollama-, vLLM- en PyTorch-modellen bevat, plus een assistent voor het creëren van clusters. Voor een klein team kan het winnen van meerdere dagen aan integratie deels de prijs rechtvaardigen.
Hoewel een goedkoper assemblage op basis van consumentencomponenten meer ruwe prestaties kan bieden, vereist dit meer configuratie, onderhoud en geheugencompromissen.
Lokaal rekenen beantwoordt drie cruciale behoeften:
- Privacy: Documenten, code of onderzoeksgegevens blijven binnen de organisatie.
- Voorspelbaarheid: Een aangeschaftte machine factureert niet per token en kan functioneren zelfs als de externe dienst verandert.
- Experimenteren op laag niveau: Met toegang tot het model, de gewichten en de infrastructuur.
Deze voordelen moeten echter worden afgewogen tegen elektriciteit, administratie en hardwarevernieuwing. De 64 Go-versie beantwoordt ook aan de toenemende geheugendruk binnen het AI-ecosysteem. Nvidia stelt een modulaire upgrade voor, maar behoudt tegelijkertijd strenge controle over de hardware en de software-stack.
Afweging: Aankoop versus Huren
Met $4.999 betekent 'goedkoop' dus niet goedkoop. Twee units overtreffen de kosten van vele werkstations en komen in de buurt van de prijs van een infrastructuur die vergeleken moet worden met het huren van GPU’s in de cloud. Een team met onregelmatige lasten kan het prefereren om capaciteit te huren. Een ander dat dagelijks gevoelige gegevens verwerkt of werkt offline, kan de machine afschrijven. Het rekenwerk moet de bezettingsgraad meenemen, niet alleen de aankoopprijs.
Het compacte formaat opent eindelijk laboratorium-, kantoor- of veldgebruik dat onmogelijk is met een traditionele server. De DGX Spark 64 Go is daarmee een drempelverlager, geen democratisering. Het maakt het mogelijk om binnen de Nvidia-stack te beginnen met minder geheugen en daarna de configuratie uit te breiden.
De relevantie zal hoog zijn voor teams die precies weten welke modellen ze willen uitvoeren, hoe vaak en waarom de cloud niet geschikt is. Voor anderen loopt het risico dat de prijs en de complexiteit van koppeling de belofte van lokale soevereiniteit veranderen in onderbenutte hardware. Voordat een aankoop wordt overwogen, moeten het doelmodel op 64 Go getest worden, moet een jaargebruik berekend worden en moeten twee verbonden Sparks vergeleken worden met een 128 Go-machine of de cloud; de beste keuze hangt af van de bezettingsgraad, niet van de slogan 'lokale AI'.