Google non presenta Gemini 4 Argon come un chatbot più prolisso, ma come un modello in grado di portare avanti lavori tecnici per periodi molto più lunghi. Il limite di output annunciato di un milione di token apre la strada a migrazioni e ricerche di codice su larga scala; sposta anche il problema sul controllo, sui costi e sulla verifica di traiettorie che nessun essere umano può rileggere integralmente in tempo reale.
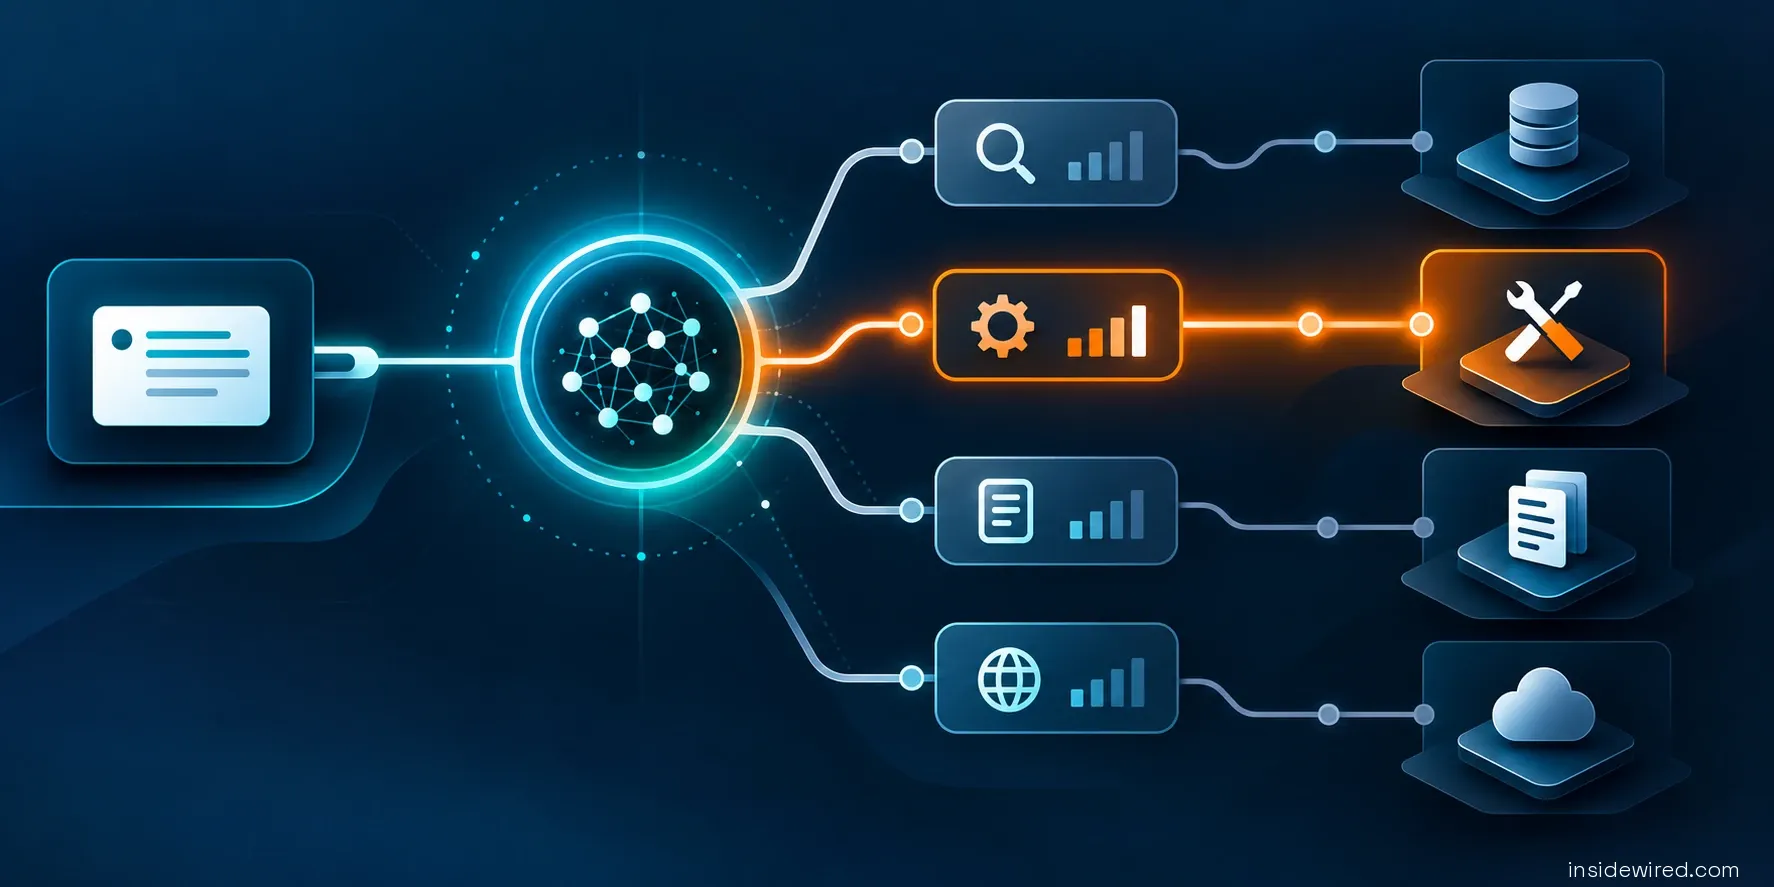
Un milione di token in uscita non è un invito a produrre un rapporto interminabile. Per Google, il nuovo limite di Gemini 4 Argon deve consentire al modello di completare lavori composti da migliaia di fasi: esaminare ampi repository di codice, proporre una migrazione, eseguire test, correggere errori e ricominciare. La generazione diventa così la traccia di una traiettoria di agente piuttosto che un testo destinato alla lettura end-to-end.
Il salto tecnologico dei token di output
Il salto annunciato è spettacolare: Google sta passando da 64.000 a un milione di token in output. È cruciale non confondere questa cifra con la finestra di contesto, che misura ciò che il modello può ricevere come input. Questo limite si riferisce invece alla quantità massima che il sistema è in grado di produrre durante un task specifico. In un uso tecnico, questi token possono contenere codice, comandi, analisi intermedie e correzioni successive. L'interesse risiede quindi meno nella lunghezza visibile e più nella capacità del modello di mantenere l'impegno verso un obiettivo stabilito per tutta la durata dell'operazione.
Risultati e benchmark di Argon
Google ha illustrato diversi risultati interni che dimostrano questa potenza potenziale. Si stima che Argon avrebbe contribuito a liberare circa 300 terabyte (tB) di archiviazione, con un potenziale stimato tra 500 tB e un petabyte (PB). Inoltre, il modello ha partecipato a migrazioni su Rust, compreso un lavoro che ha toccato circa 800.000 righe del kernel Fuchsia. Il gruppo menziona anche un miglioramento del 40% in un compito di ottimizzazione quantistica. Sebbene questi esempi forniscano un'idea della portata raggiunta, rappresentano casi selezionati e devono essere documentati e replicati per distinguere la capacità generale da un'integrazione altamente circoscritta.
Anche i benchmark pubblicati confermano questa linea di forza: Google annuncia risultati significativi come 77,9 su DeepSWE e 51,3 su AutomationBench. Un punteggio elevato indica che il modello è capace di pianificare, programmare e utilizzare strumenti con efficacia. Tuttavia, questi test non misurano necessariamente la manutenibilità di un cambio specifico, la qualità di un'analisi di business o la capacità intrinseca di riconoscere quando un obiettivo è mal formulato.
Governance, Costi e Controllo Operativo
L'aumento della lunghezza operativa solleva immediatamente questioni di supervisione. Poiché nessun responsabile leggerà riga per riga un output di questa dimensione, la fiducia dovrà basarsi su validazioni intermedie rigorose: test automatici, verifica dei tipi, politiche di accesso, confronti di risultati e approvazione umana nelle fasi cruciali. Un agente lungo non può permettersi di operare in un ambiente troppo aperto solo perché è più capace; deve essere invece suddiviso in fasi osservabili con budget e criteri di arresto ben definiti.
Il costo operativo fa parte integrante della governance del sistema. Google ha stabilito che per la fase introduttiva il tariff sarà di 2 dollari per milione di token in input e 10 dollari in output. Una traiettoria che consuma l'intero limite costerebbe quindi almeno dieci dollari solo per la generazione, senza considerare nuovi tentativi, chiamate a strumenti o contesto. Questo importo è contenuto rispetto al lavoro di un team di ingegneri, ma diventa significativo quando un'azienda autorizza cicli mal controllati o rilascia centinaia di agenti contemporaneamente. La misura utile sarà sempre il costo di un task validato, non quello del singolo token consumato.
La disponibilità limitata rafforza la prudenza operativa. Google ha riservato inizialmente Argon ai difensori cyber selezionati tramite Fairwind, prima di una successiva apertura più ampia. Questo approccio riconosce implicitamente che le capacità di autonomia e codice possono essere utilizzate sia per scopi difensivi che offensivi. Il dispiegamento graduale è un meccanismo che permette al gruppo di osservare gli usi, testare i controlli e aggiustare i limiti in tempo reale.
Oltre la semplice lunghezza del testo
Per gli sviluppatori, Argon promette di cambiare radicalmente la granularità del lavoro affidato all'IA. Fino ad oggi si ha la tendenza a delegare una funzione specifica, un test o un'analisi localizzata. Una traiettoria molto lunga consente invece di considerare la modernizzazione di un intero sottosistema, una ricerca documentale esaustiva o un'ottimizzazione che produce e valuta numerosi ipotesi.
La responsabilità umana non scompare: resta fondamentale definire l'obiettivo con precisione, costruire l'ambiente di test appropriato e decidere quali modifiche meritano di essere mantenute. La promessa di Argon non è semplicemente "più testo", ma la capacità di mantenere una continuità di ragionamento e azione per un periodo prima inaccessibile. Se questa continuità è accompagnata da punti di controllo e validazione, può ridurre il costo di lavori gravosi e massivi. Senza visibilità sulle fasi intermedie, c'è invece il rischio di produrre modifiche considerevoli la cui logica risulta estremamente difficile da auditare per gli umani.
Il milione di token rappresenta un'infrastruttura potentissima per gli agenti; il suo valore non è intrinseco alla sua lunghezza, ma dipenderà dalla qualità del sistema di validazione costruito attorno ad essa. Il vero benchmark sarà un task lungo che sia consegnato, testato e pienamente comprensibile da un team umano, piuttosto che la mera capacità grezza di raggiungere il limite massimo di token.