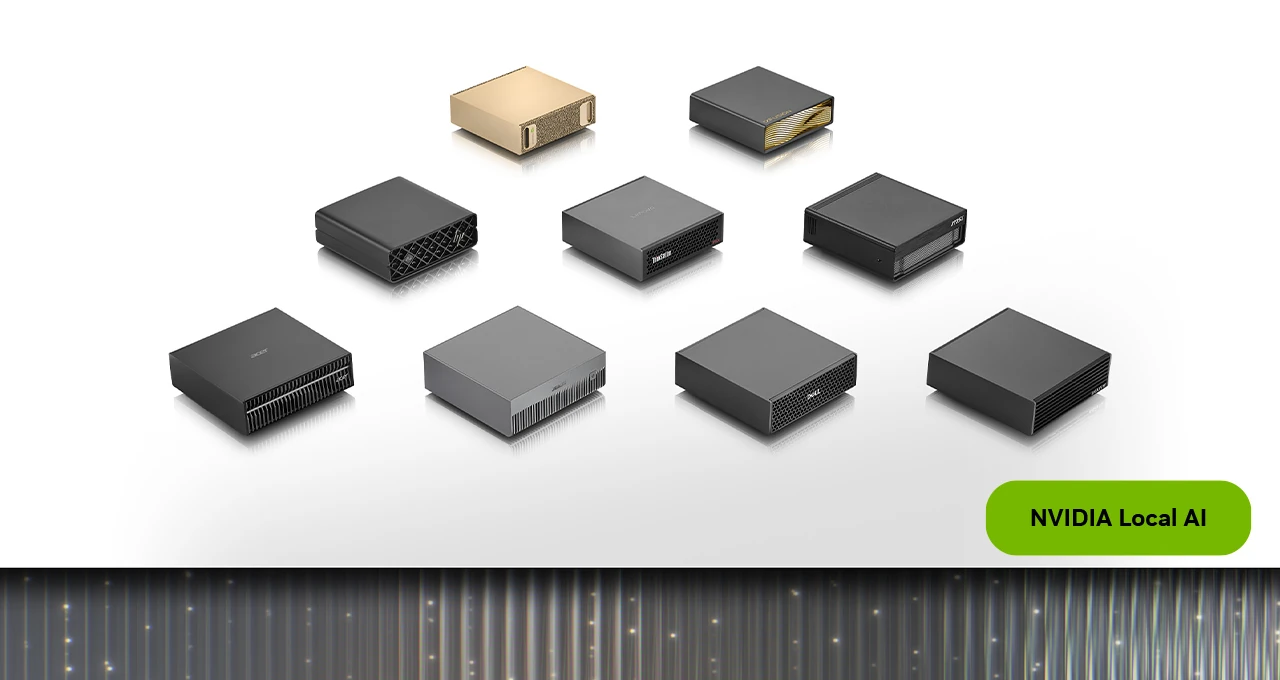
Nvidia ha lanzado su mini-supercomputadora DGX Spark en versión de 64 GB por $4,999 y ofrece la posibilidad de conectar dos unidades para alcanzar una memoria total agregada de 128 GB. Si bien esta oferta hace que el ecosistema GB10 sea más accesible que el modelo de 128 GB, la palabra «accesible» sigue siendo relativa: esta máquina está dirigida a equipos que valoran la privacidad y el prototipado local, no al público general en busca de un PC con IA.
DGX Spark: Una Puerta de Entrada para Modelos de IA Locales
Nvidia presenta el nuevo DGX Spark de 64 GB como una puerta de entrada optimizada para el desarrollo local de modelos de inteligencia artificial. La máquina conserva el formato compacto y la arquitectura GB10 de la familia, pero reduce la memoria unificada en comparación con su contraparte de 128 GB. Su precio anunciado de $4,999, con disponibilidad prevista a partir del 23 de octubre por parte de sus socios, confirma que se trata de una herramienta profesional especializada y no de un mini PC convencional.
La memoria es el parámetro más crucial en esta categoría. Para ejecutar un modelo localmente, la capacidad disponible determina lo que puede cargarse incluso antes de considerar la potencia de cálculo. Nvidia indica que un DGX Spark de 64 GB puede soportar modelos de hasta aproximadamente 100 mil millones de parámetros, dependiendo del formato y la cuantificación. Es importante señalar que este límite solo da un orden de magnitud para el prototipado, sin garantizar que todos los modelos sean rápidos o que toda la memoria esté disponible para el contexto y las herramientas.
Escalamiento y Rendimiento Técnico
Un aspecto destacado es la capacidad de conectar dos unidades mediante la interfaz ConnectX-7. Al hacer esto, el pool alcanza los 128 GB, permitiendo la ejecución de modelos de hasta 200 mil millones de parámetros. Esta configuración modular resulta muy atractiva para un equipo que planea adquirir una primera máquina y luego expandir su capacidad.
Sin embargo, es fundamental comparar este enfoque con un sistema integrado de 128 GB: distribuir un modelo a través de unidades separadas introduce complejidades de software y comunicaciones entre los gabinetes, lo cual está sujeto a límites según las arquitecturas compatibles.
En términos de rendimiento, Nvidia anuncia el doble de ancho de banda y hasta 1,7 veces más rendimiento en una prueba realizada con Qwen 3.8 27B. Como siempre sucede con los resultados proporcionados por un fabricante, este describe un escenario específico. El rendimiento variará según la cuantificación, la longitud del contexto, el número de usuarios y el motor de inferencia. Por ello, las pruebas independientes deberán medir métricas como el throughput de tokens, la latencia en el primer token, el consumo y la estabilidad durante sesiones largas.
El Ecosistema Software y la Necesidad Local
El valor del DGX Spark no reside solo en su ficha técnica, sino también en el ecosistema que proporciona. Nvidia suministra un stack completo que incluye CUDA, herramientas para modelos como Nemotron, Ollama, vLLM y PyTorch, además de asistentes diseñados para la creación de clústeres. Para un equipo pequeño, ganar varios días de integración puede justificar parte del coste inicial. Aunque un montaje más económico con componentes de consumo masivo podría ofrecer mayor rendimiento bruto, requerirá una inversión significativa en configuración, mantenimiento y compromisos de memoria.
El cálculo local responde a tres necesidades fundamentales:
- Privacidad: Los documentos, código o datos de investigación se mantienen íntegramente dentro de la organización.
- Previsibilidad: Una máquina propia no factura por cada token y puede funcionar incluso si el servicio remoto experimenta interrupciones.
- Experimentación a bajo nivel: Permite acceso directo al modelo, a los pesos y a la infraestructura subyacente.
Estos beneficios deben sopesarse siempre con el coste operativo de la electricidad, la administración y el reemplazo del hardware. A $4,999, «más económico» no significa barato; dos unidades superan el costo de numerosas estaciones de trabajo e incluso se acercan al precio de una infraestructura que debe compararse con el alquiler de GPU en la nube. Un equipo con gastos irregulares podría preferir alquilar capacidad, mientras que otro que maneja datos sensibles o desarrolla sin conexión puede amortizar la máquina localmente. El cálculo tiene que integrar la tasa de uso, y no solamente el precio de compra.
Usos y Alcance del DGX Spark
La versión de 64 GB también aborda la creciente presión sobre la memoria en el ecosistema IA, dado que tanto los modelos como las ventanas de contexto aumentan su tamaño, haciendo que las configuraciones con grandes cantidades de memoria sigan siendo escasas y costosas. Nvidia promueve una escalabilidad modular, pero mantiene un control estricto sobre el hardware y la pila de software. El éxito del sistema dependerá de la capacidad real de conectar las unidades sin atrapar a los usuarios en unas pocas demostraciones optimizadas.
El formato compacto permite usos en entornos de laboratorio, oficina o campo que serían imposibles con un servidor tradicional. Sin embargo, es crucial entender que esto no convierte al Spark en una computadora portátil ni en un puesto generalista; factores como el ruido, el calor, la conectividad, el almacenamiento y los protocolos de copias de seguridad son esenciales en una instalación real. Las empresas también deberán definir políticas de acceso: un modelo local solo protege los datos si la máquina, sus registros y sus respaldos están correctamente asegurados.
En resumen, el DGX Spark de 64 GB representa una reducción de barreras, no necesariamente una democratización total. Permite ingresar a la pila tecnológica de Nvidia con menos memoria y luego ampliar la configuración. Su relevancia será máxima para los equipos que saben exactamente qué modelos desean ejecutar, con qué frecuencia, y por qué la nube resulta inviable. Para otros, el coste y la complejidad del acoplamiento corren el riesgo de transformar la promesa de soberanía local en hardware subutilizado.
Antes de tomar una decisión de compra, es crucial probar el modelo objetivo directamente con 64 GB, calcular un año estimado de uso, y comparar las opciones: dos Sparks conectados vs. una máquina de 128 GB o la nube. La mejor opción dependerá siempre de la tasa de uso, no del eslogan «IA local».