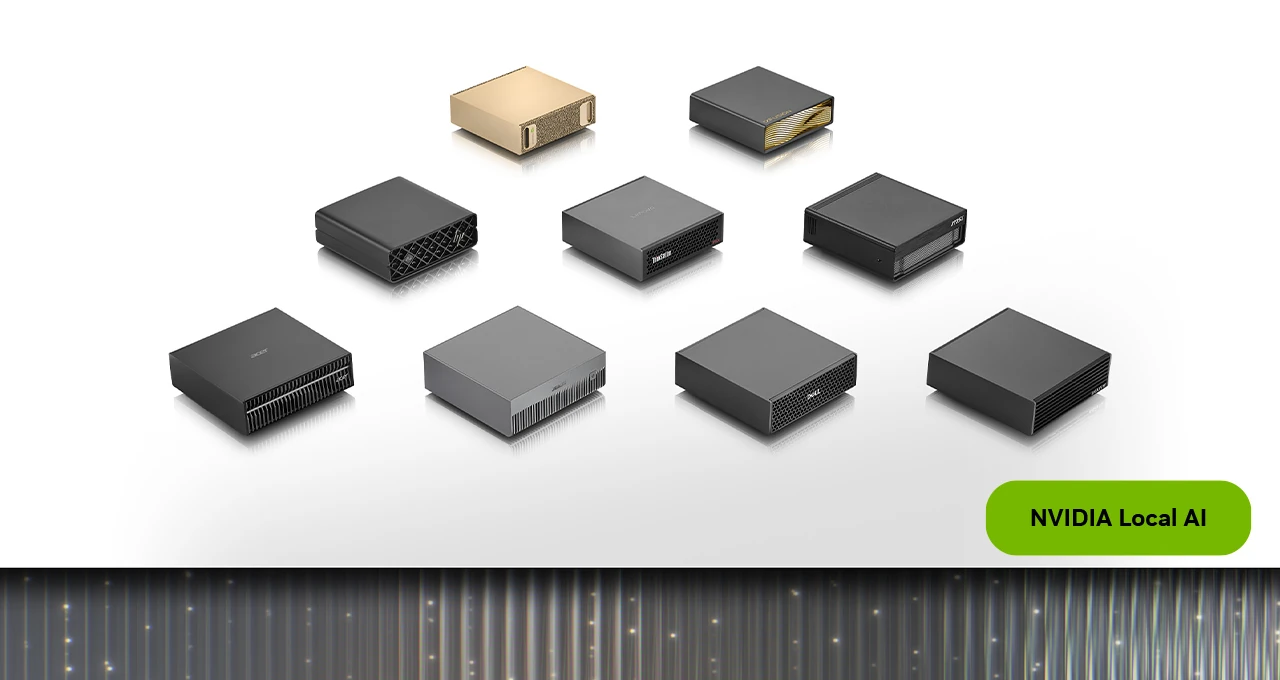
Nvidia bringt seinen Mini-Supercomputer DGX Spark in der Version mit 64 GB zu einem Preis von 4.999 US-Dollar heraus und bietet die Möglichkeit, zwei Einheiten miteinander zu verbinden, um auf aggregierte Speicher von 128 GB zuzugreifen. Dieses Angebot macht das GB10-Ökosystem zugänglicher als das 128-GB-Modell; allerdings bleibt der Begriff „zugänglich“ relativ: Die Maschine richtet sich explizit an Teams, die Wert auf Vertraulichkeit und lokales Prototyping legen – nicht an ein breites Publikum, das einen herkömmlichen AI-PC sucht.
Der Einstieg in die lokale KI-Entwicklung
Mit dem neuen DGX Spark 64 Go präsentiert Nvidia einen spezialisierten Zugang zur lokalen Entwicklung von KI-Modellen. Der Rechner behält dabei das kompakte Format und die GB10-Architektur der Familie bei, reduziert aber den gemeinsamen Speicher im Vergleich zu seiner 128-GB-Version. Sein angekündigter Preis von 4.999 US-Dollar, mit einer Verfügbarkeit ab dem 23. Oktober über Partner, unterstreicht, dass es sich um ein spezialisiertes professionelles Werkzeug und nicht um einen herkömmlichen Mini-PC handelt.
Der Speicher ist dabei das zentrale Element dieser Kategorie. Um ein Modell lokal auszuführen, bestimmt die verfügbare Kapazität oft, was geladen werden kann, noch bevor die reine Rechenleistung ins Spiel kommt. Nvidia gibt an, dass ein DGX Spark 64 Go Modelle mit bis zu etwa 100 Milliarden Parametern verarbeiten kann – abhängig vom Format und der Quantisierung. Dieser Maximalwert ist lediglich als Größenordnung für das Prototyping gedacht; er bedeutet nicht, dass all diese Modelle schnell sind oder dass der gesamte Speicher auch für den Kontext und die Tools frei bleibt.
Erweiterbarkeit und Leistungsdetails
Der Fokus liegt stark auf dem Anschließen von zwei Einheiten mittels der ConnectX-7-Schnittstelle. Dadurch steigt der Pool auf 128 GB, und Nvidia wirbt damit, Modelle bis zu 200 Milliarden Parametern auszuführen. Diese Konfiguration ist besonders attraktiv für ein Team, das zunächst eine einzelne Maschine erwerben möchte und deren Kapazität später erweitern kann. Es muss jedoch berücksichtigt werden, dass die Verteilung eines Modells Kommunikationen zwischen den Gehäusen mit sich bringt, was zu Softwarekomplexität und Limitierungen je nach unterstützter Architektur führen kann – im Vergleich zu einem integrierten 128-GB-System.
Nvidia kündigt doppelt so viel Bandbreite und bis zu 1,7-mal höhere Leistung in einem Test an, der mit Qwen 3.8 27B durchgeführt wurde. Wie bei Herstellerergebnissen ist hier von einem präzisen Szenario die Rede. Die tatsächliche Leistung variiert je nach Quantisierung, Kontextlänge, Anzahl der Nutzer und dem verwendeten Inferenzmotor. Daher müssen unabhängige Tests stets den Token-Durchsatz, die Latenz beim ersten Token, den Stromverbrauch und die Stabilität bei langen Sitzungen messen.
Der Wert des DGX Spark liegt ebenso in seinem gesamten Umfeld wie auf seinem Datenblatt. Nvidia liefert einen umfassenden Stack, der unter anderem CUDA, Tools für die Modelle Nemotron, Ollama, vLLM und PyTorch sowie ein Assistentenprogramm zur Clustererstellung umfasst. Für ein kleines Team können mehrere Tage an Integrationszeit durch diesen Stack gespart werden, was einen Teil des Kaufpreises rechtfertigen kann. Obwohl ein günstiger zusammengebautes System für den Endkundenmarkt mehr Rohleistung bieten könnte, erfordert es deutlich mehr Konfiguration, Wartung und Kompromisse beim Speicher.
Die Argumente für lokale Berechnung
Lokale Berechnung bedient drei zentrale Bedürfnisse:
- Datenschutz: Dokumente, Code oder Forschungsdaten verbleiben vollständig in der Organisation.
- Vorhersehbarkeit: Eine gekaufte Maschine berechnet nicht pro Token und kann funktionieren, selbst wenn ein externer Service ausfällt.
- Experimentieren auf niedrigem Niveau (Low-Level): Direkter Zugriff auf das Modell, die Gewichte und die gesamte Infrastruktur wird gewährleistet.
Diese Vorteile müssen gegen Faktoren wie Elektrizität, Administration und den Hardware-Refresh abgewogen werden. Bei 4.999 US-Dollar bedeutet „günstiger“ demnach nicht billig; zwei Einheiten übersteigen bereits die Kosten vieler Workstations und nähert sich preislich einem Rechenzentrum – was man stets mit der Miete von GPUs in der Cloud vergleichen muss. Ein Team mit unregelmäßigen Lasten könnte daher eher Kapazität mieten. Das jedoch täglich sensible Daten verarbeitet oder offline entwickelt, kann die Maschine amortisieren, wobei hierbei zwingend der Auslastungsgrad und nicht nur der Kaufpreis berücksichtigt werden muss.
Das kompakte Format eröffnet zudem Lab-, Büro- oder Außendienstszenarien, die mit einem traditionellen Server unmöglich waren. Es ist wichtig zu betonen, dass der Spark zwar durch seine Ästhetik überzeugt, aber Lärm, Wärme, Anschlüsse, Speicherung und Sicherung bei einer realen Installation kritisch sind. Unternehmen müssen zudem Zugriffsrichtlinien definieren: Ein lokal ausgeführtes Modell schützt Daten nur dann, wenn die Maschine, ihre Logs und alle Kopien ordnungsgemäß gesichert sind.
Der DGX Spark 64 Go ist somit weniger eine Senkung der Hürde als vielmehr ein gewisser Eintrittspunkt. Er ermöglicht es, in den Nvidia-Stack mit begrenztem Speicher einzusteigen und die Konfiguration später zu erweitern. Seine Relevanz wird hoch sein für Teams, die genau wissen, welche Modelle sie ausführen wollen, wie oft und warum die Cloud nicht geeignet ist. Für alle anderen könnten der Preis sowie die Komplexität des Zusammenbaus das Versprechen lokaler Souveränität in einem Unterauslastungsgerät verflüchtigen lassen.
Vor dem Kauf sollte stets das Zielmodell auf 64 GB getestet werden, ein Jahr Nutzung präzise kalkuliert und ein umfassender Vergleich zwischen zwei verbundenen Sparks, einer integrierten 128-GB-Maschine oder der Cloud gezogen werden. Die beste Wahl hängt fundamental vom tatsächlichen Nutzungsgrad ab, nicht von einem Slogan wie „lokale KI“.